Szybki quiz – przypomnienie poprzedniej lekcji
Temat poprzedniej lekcji: wykresy (Matplotlib i Seaborn). Odpowiedzi są pod pytaniami.
Pytanie 1. Dopasuj funkcję do rodzaju wykresu: plt.plot(), plt.scatter(), plt.bar(), plt.hist(), plt.pie(). Rodzaje wykresów: kołowy, punktowy, słupkowy, histogram, liniowy.
Odpowiedź
Odpowiedź: plt.plot() – liniowy, plt.scatter() – punktowy, plt.bar() – słupkowy, plt.hist() – histogram, plt.pie() – kołowy.
Pytanie 2. Znajdź błąd w kodzie. Dlaczego wykres się nie narysuje?
import matplotlib.pyplot as plt

x = [1, 2, 3]
y = [4, 5]
plt.plot(x, y)
plt.show()
Odpowiedź
Odpowiedź: Listy x i y mają różną długość (3 i 2 elementy), więc plt.plot() zgłosi błąd (ValueError). Każdej wartości na osi X musi odpowiadać wartość na osi Y.
Pytanie 3. Wykres ma dwie linie z parametrem label=, ale legenda się nie pokazuje. Którą funkcję trzeba dodać przed plt.show()?
Odpowiedź
Odpowiedź: plt.legend(). Samo label= tylko nadaje nazwę linii, legendę wyświetla dopiero plt.legend().
Pytanie 4. Co należy uzupełnić, aby zapisać wykres do pliku w rozdzielczości 300 dpi?
plt.savefig('wykres.png', ____=300)Odpowiedź
Odpowiedź: dpi, czyli plt.savefig('wykres.png', dpi=300).
Pytanie 5. Po wykonaniu fig, axes = plt.subplots(2, 2) chcesz narysować wykres w prawym górnym polu siatki. Jak się do niego odwołać?
Odpowiedź
Odpowiedź: axes[0, 1] (wiersz 0, kolumna 1). Indeksy liczymy od zera.
Pytanie 6. Co zrobi sns.heatmap(korelacja, annot=True) i co w tym kodzie robi korelacja = df.corr()?
Odpowiedź
Odpowiedź: df.corr() oblicza macierz korelacji między kolumnami DataFrame. sns.heatmap() rysuje ją jako mapę kolorów, a annot=True wpisuje wartości liczbowe w komórki.
Algorytm to precyzyjny zestaw kroków prowadzących do rozwiązania problemu.
Dlaczego algorytmy?
- Efektywność – szybsze przetwarzanie danych
- Optymalizacja – mniej zasobów (pamięć, czas)
- Zrozumienie podstaw informatyki
- Rozmowy kwalifikacyjne
W tej lekcji:
- Algorytmy sortowania
- Algorytmy przeszukiwania
- Złożoność obliczeniowa (Big O)
Złożoność obliczeniowa (Big O Notation)
Złożoność obliczeniowa mierzy jak szybko rośnie czas wykonania algorytmu wraz ze wzrostem rozmiaru danych.
Notacja Big O
O(n) – „Big O of n” – opisuje najgorszy przypadek.
Najczęstsze złożoności (od najlepszej do najgorszej):
| Notacja | Nazwa | Przykład | Opis |
|---|---|---|---|
| O(1) | Stała | Dostęp do elementu tablicy | Niezależnie od rozmiaru |
| O(log n) | Logarytmiczna | Przeszukiwanie binarne | Bardzo szybkie |
| O(n) | Liniowa | Przeszukiwanie liniowe | Wprost proporcjonalne |
| O(n log n) | Liniowo-logarytmiczna | Merge sort, Quick sort | Dobre sortowanie |
| O(n²) | Kwadratowa | Bubble sort, Selection sort | Wolne dla dużych danych |
| O(2^n) | Wykładnicza | Niektóre rekurencje | Bardzo wolne |
| O(n!) | Silnia | Permutacje | Ekstremalnie wolne |
Wizualizacja wzrostu
n = 10:
O(1)      = 1
O(log n)  = 3
O(n)      = 10
O(n log n)= 30
O(n²)     = 100
O(2^n)    = 1024

n = 1000:
O(1)      = 1
O(log n)  = 10
O(n)      = 1000
O(n log n)= 10000
O(n²)     = 1000000
O(2^n)    = ???  (za dużo!)
Przykłady złożoności
# O(1) - Stała
def get_first(lista):
    return lista[0]  # Zawsze 1 operacja

# O(n) - Liniowa
def contains(lista, element):
    for item in lista:  # n operacji
        if item == element:
            return True
    return False

# O(n²) - Kwadratowa
def print_pairs(lista):
    for i in lista:       # n razy
        for j in lista:   # n razy
            print(i, j)   # n * n = n²
Algorytmy sortowania
Sortowanie to uporządkowanie elementów według określonego kryterium.
1. Bubble Sort (Sortowanie bąbelkowe)
Idea: Porównuj sąsiednie elementy i zamieniaj je miejscami jeśli są w złej kolejności. Powtarzaj aż lista będzie posortowana.
Złożoność:
- Czasowa: O(n²) – najgorszy i średni przypadek
- Czasowa: O(n) – najlepszy przypadek (lista już posortowana)
- Pamięciowa: O(1) – sortowanie in-place
Kiedy używać:
- Małe zbiory danych
- Dane prawie posortowane
- Cel edukacyjny
def bubble_sort(lista):
    """
    Sortowanie bąbelkowe.
    Porównuje sąsiednie elementy i zamienia je miejscami.
    """
    n = len(lista)

    # Zewnętrzna pętla - liczba przejść
    for i in range(n):
        # Flaga - czy było zamiana
        zamiana = False

        # Wewnętrzna pętla - porównania
        for j in range(0, n - i - 1):
            # Jeśli element jest większy od następnego
            if lista[j] > lista[j + 1]:
                # Zamień miejscami
                lista[j], lista[j + 1] = lista[j + 1], lista[j]
                zamiana = True

        # Jeśli nie było zamiany, lista jest posortowana
        if not zamiana:
            break

    return lista

# Test
dane = [64, 34, 25, 12, 22, 11, 90]
print("Przed:", dane)
bubble_sort(dane)
print("Po:", dane)
# Po: [11, 12, 22, 25, 34, 64, 90]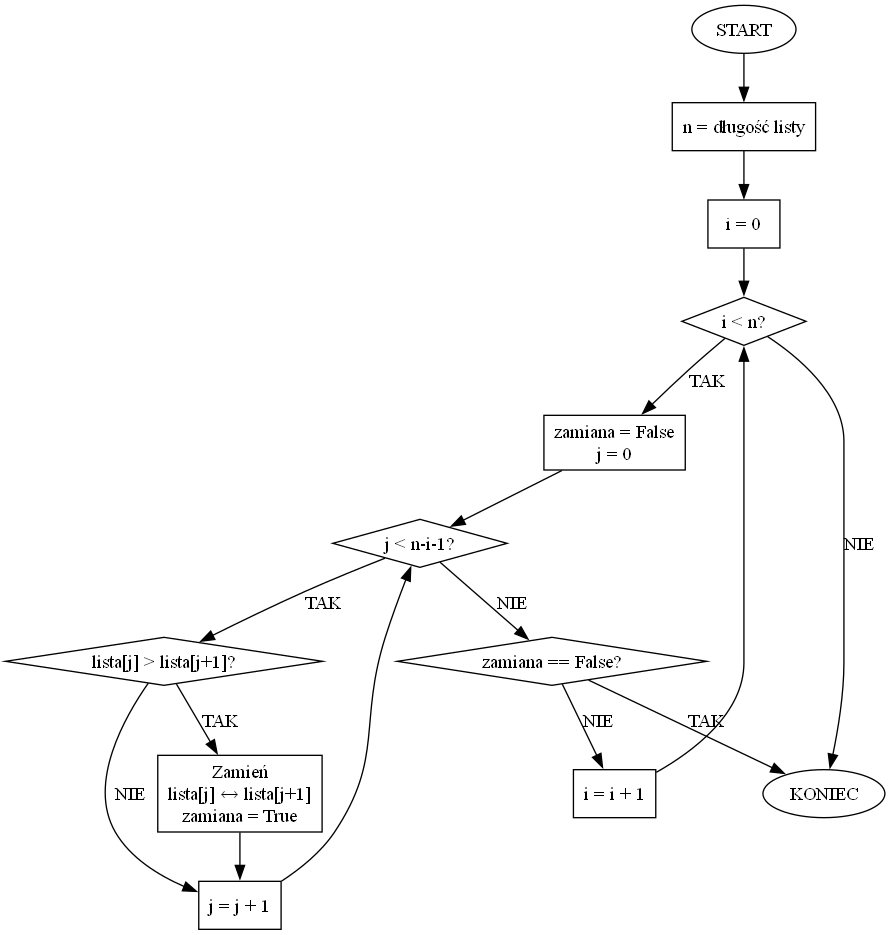
Wizualizacja (pierwsze przejście):
[64, 34, 25, 12, 22, 11, 90]
 64>34 → zamień
[34, 64, 25, 12, 22, 11, 90]
    64>25 → zamień
[34, 25, 64, 12, 22, 11, 90]
       64>12 → zamień
[34, 25, 12, 64, 22, 11, 90]
          64>22 → zamień
[34, 25, 12, 22, 64, 11, 90]
             64>11 → zamień
[34, 25, 12, 22, 11, 64, 90]
                64<90 → OK
2. Selection Sort (Sortowanie przez wybieranie)
Idea: Znajdź najmniejszy element i umieść go na początku. Powtarzaj dla pozostałej części.
Złożoność:
- Czasowa: O(n²) – zawsze
- Pamięciowa: O(1)
def selection_sort(lista):
    """
    Sortowanie przez wybieranie.
    Znajduje minimum i umieszcza na początku.
    """
    n = len(lista)

    # Przejdź przez wszystkie elementy
    for i in range(n):
        # Znajdź indeks najmniejszego elementu
        min_idx = i
        for j in range(i + 1, n):
            if lista[j] < lista[min_idx]:
                min_idx = j

        # Zamień znaleziony minimum z pierwszym elementem
        lista[i], lista[min_idx] = lista[min_idx], lista[i]

    return lista

# Test
dane = [64, 25, 12, 22, 11]
print("Przed:", dane)
selection_sort(dane)
print("Po:", dane)
# Po: [11, 12, 22, 25, 64]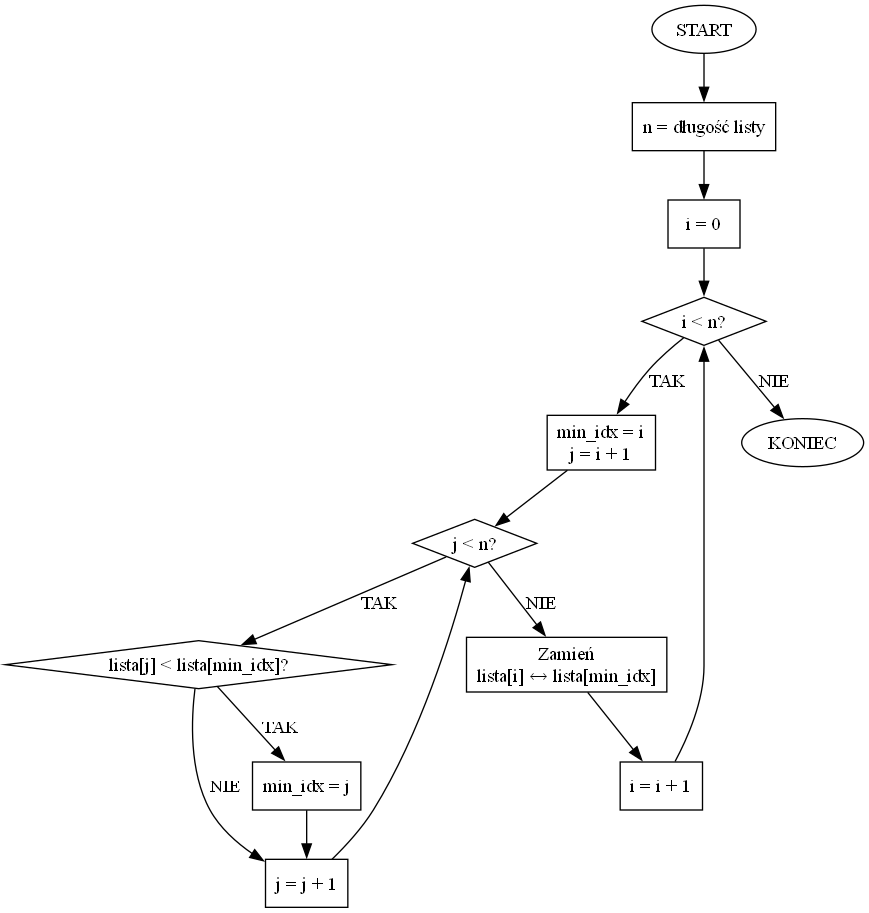
Wizualizacja:
[64, 25, 12, 22, 11]
 ^               ^  min=11, zamień
[11, 25, 12, 22, 64]
     ^   ^          min=12, zamień
[11, 12, 25, 22, 64]
         ^   ^      min=22, zamień
[11, 12, 22, 25, 64]
             ^  ^   min=25, już OK
[11, 12, 22, 25, 64] ✓
3. Insertion Sort (Sortowanie przez wstawianie)
Idea: Bierz kolejne elementy i wstawiaj je we właściwe miejsce w już posortowanej części.
Złożoność:
- Czasowa: O(n²) – najgorszy przypadek
- Czasowa: O(n) – najlepszy przypadek (lista posortowana)
- Pamięciowa: O(1)
Kiedy używać:
- Małe zbiory danych
- Dane prawie posortowane
- Sortowanie online (elementy przychodzą po kolei)
def insertion_sort(lista):
    """
    Sortowanie przez wstawianie.
    Jak sortowanie kart w ręce.
    """
    n = len(lista)

    # Zacznij od drugiego elementu
    for i in range(1, n):
        # Element do wstawienia
        key = lista[i]
        j = i - 1

        # Przesuń elementy większe od key o jedno miejsce w prawo
        while j >= 0 and lista[j] > key:
            lista[j + 1] = lista[j]
            j -= 1

        # Wstaw key na właściwe miejsce
        lista[j + 1] = key

    return lista

# Test
dane = [12, 11, 13, 5, 6]
print("Przed:", dane)
insertion_sort(dane)
print("Po:", dane)
# Po: [5, 6, 11, 12, 13]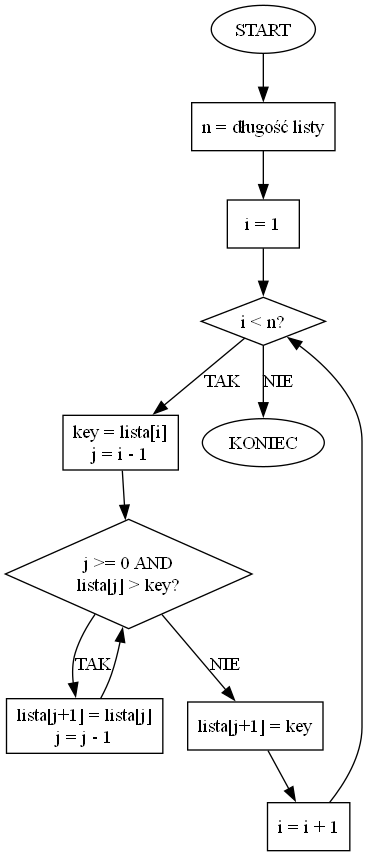
Analogia: Jak sortowanie kart w ręce – bierzesz kolejną kartę i wstawiasz ją we właściwe miejsce.
4. Merge Sort (Sortowanie przez scalanie)
Idea: Dziel listę na połowy, sortuj rekurencyjnie, następnie scalaj posortowane połowy.
Złożoność:
- Czasowa: O(n log n) – zawsze!
- Pamięciowa: O(n) – wymaga dodatkowej pamięci
Kiedy używać:
- Duże zbiory danych
- Stabilne sortowanie (zachowuje kolejność równych elementów)
- Gwarantowana wydajność O(n log n)
def merge_sort(lista):
    """
    Sortowanie przez scalanie (rekurencyjne).
    Dziel i zwyciężaj.
    """
    # Warunek bazowy - lista o długości 1 jest posortowana
    if len(lista) <= 1:
        return lista

    # Podziel na dwie połowy
    srodek = len(lista) // 2
    lewa = lista[:srodek]
    prawa = lista[srodek:]

    # Rekurencyjnie posortuj połowy
    lewa = merge_sort(lewa)
    prawa = merge_sort(prawa)

    # Scal posortowane połowy
    return merge(lewa, prawa)

def merge(lewa, prawa):
    """Scala dwie posortowane listy."""
    wynik = []
    i = j = 0

    # Porównuj elementy z obu list
    while i < len(lewa) and j < len(prawa):
        if lewa[i] <= prawa[j]:
            wynik.append(lewa[i])
            i += 1
        else:
            wynik.append(prawa[j])
            j += 1

    # Dodaj pozostałe elementy
    wynik.extend(lewa[i:])
    wynik.extend(prawa[j:])

    return wynik

# Test
dane = [38, 27, 43, 3, 9, 82, 10]
print("Przed:", dane)
posortowane = merge_sort(dane)
print("Po:", posortowane)
# Po: [3, 9, 10, 27, 38, 43, 82]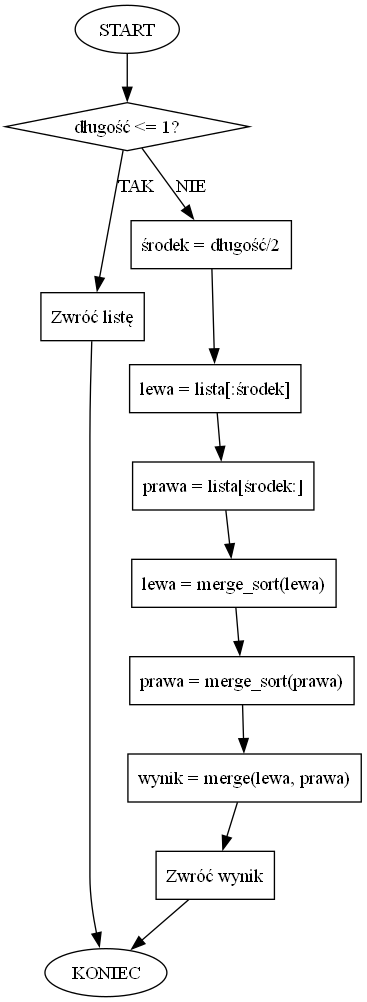
Wizualizacja:
[38, 27, 43, 3, 9, 82, 10]
       ↓ dziel ↓
[38, 27, 43]  [3, 9, 82, 10]
  ↓ dziel ↓    ↓ dziel ↓
[38] [27, 43]  [3, 9] [82, 10]
       ↓          ↓       ↓
    [27, 43]    [3, 9]  [10, 82]
        ↓ scal ↓          ↓
    [27, 38, 43]    [3, 9, 10, 82]
           ↓ scal ↓
    [3, 9, 10, 27, 38, 43, 82]
5. Quick Sort (Sortowanie szybkie)
Idea: Wybierz element (pivot), podziel na mniejsze i większe, sortuj rekurencyjnie.
Złożoność:
- Czasowa: O(n log n) – średni przypadek
- Czasowa: O(n²) – najgorszy (rzadko)
- Pamięciowa: O(log n) – rekursja
Kiedy używać:
- Duże zbiory danych
- Najszybszy w praktyce (średnio)
- Wersja poniżej jest prosta do zrozumienia, ale tworzy nowe listy (nie sortuje in-place)
def quick_sort(lista):
    """
    Sortowanie szybkie.
    Wybiera pivot i dzieli na mniejsze/większe.
    """
    # Warunek bazowy
    if len(lista) <= 1:
        return lista

    # Wybierz pivot (środkowy element)
    pivot = lista[len(lista) // 2]

    # Podziel na trzy grupy
    mniejsze = [x for x in lista if x < pivot]
    rowne = [x for x in lista if x == pivot]
    wieksze = [x for x in lista if x > pivot]

    # Rekurencyjnie posortuj i połącz
    return quick_sort(mniejsze) + rowne + quick_sort(wieksze)

# Test
dane = [10, 7, 8, 9, 1, 5]
print("Przed:", dane)
posortowane = quick_sort(dane)
print("Po:", posortowane)
# Po: [1, 5, 7, 8, 9, 10]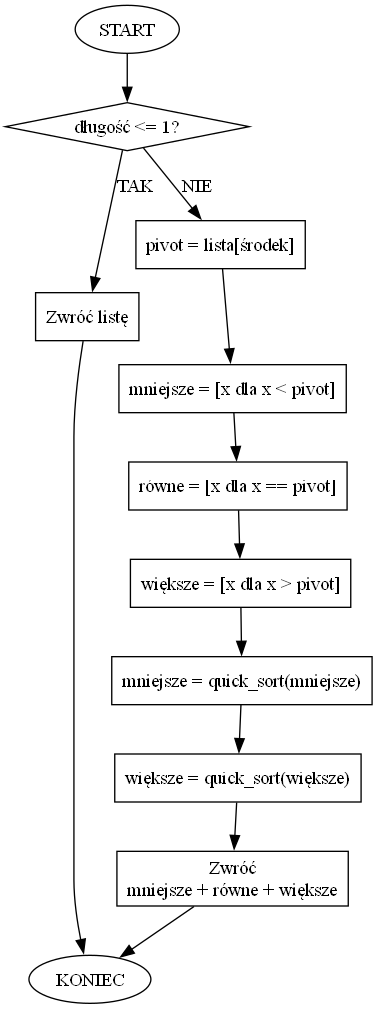
Wizualizacja:
[10, 7, 8, 9, 1, 5]  pivot=8
      ↓
mniejsze: [7, 1, 5]
rowne: [8]
wieksze: [10, 9]
      ↓ sortuj rekurencyjnie
[1, 5, 7] + [8] + [9, 10]
      ↓
[1, 5, 7, 8, 9, 10]
Porównanie algorytmów sortowania
| Algorytm | Najlepszy | Średni | Najgorszy | Pamięć | Stabilny |
|---|---|---|---|---|---|
| Bubble Sort | O(n) | O(n²) | O(n²) | O(1) | Tak |
| Selection Sort | O(n²) | O(n²) | O(n²) | O(1) | Nie |
| Insertion Sort | O(n) | O(n²) | O(n²) | O(1) | Tak |
| Merge Sort | O(n log n) | O(n log n) | O(n log n) | O(n) | Tak |
| Quick Sort | O(n log n) | O(n log n) | O(n²) | O(n) | Nie |
| Wbudowany sort() | O(n log n) | O(n log n) | O(n log n) | O(n) | Tak |
Stabilny = zachowuje względną kolejność równych elementów.
Algorytmy przeszukiwania
1. Przeszukiwanie liniowe (Linear Search)
Idea: Sprawdź każdy element po kolei.
Złożoność:
- Czasowa: O(n)
- Pamięciowa: O(1)
Kiedy używać:
- Mała lista
- Lista nieposortowana
- Jednorazowe wyszukiwanie
def linear_search(lista, szukany):
    """
    Przeszukiwanie liniowe.
    Sprawdza każdy element po kolei.
    """
    for i in range(len(lista)):
        if lista[i] == szukany:
            return i  # Zwróć indeks
    return -1  # Nie znaleziono

# Test
dane = [10, 23, 45, 70, 11, 15]
wynik = linear_search(dane, 70)
print(f"Element 70 znajduje się na indeksie: {wynik}")  # 3

wynik = linear_search(dane, 100)
print(f"Element 100 znajduje się na indeksie: {wynik}")  # -1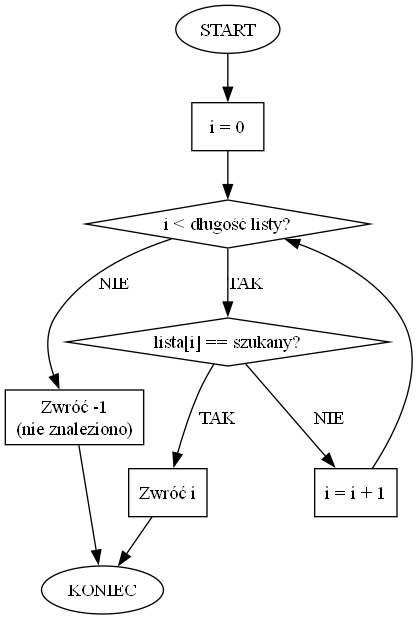
2. Przeszukiwanie binarne (Binary Search)
Idea: W posortowanej liście sprawdź środek. Jeśli szukany jest mniejszy, szukaj w lewej połowie, jeśli większy – w prawej.
Złożoność:
- Czasowa: O(log n)
- Pamięciowa: O(1) – iteracyjna, O(log n) – rekurencyjna
Wymaganie: Lista MUSI być posortowana!
Kiedy używać:
- Duża, posortowana lista
- Wielokrotne wyszukiwania
def binary_search(lista, szukany):
    """
    Przeszukiwanie binarne (iteracyjne).
    Wymaga posortowanej listy!
    """
    lewy = 0
    prawy = len(lista) - 1

    while lewy <= prawy:
        # Znajdź środek
        srodek = (lewy + prawy) // 2

        # Sprawdź środkowy element
        if lista[srodek] == szukany:
            return srodek
        elif lista[srodek] < szukany:
            # Szukaj w prawej połowie
            lewy = srodek + 1
        else:
            # Szukaj w lewej połowie
            prawy = srodek - 1

    return -1  # Nie znaleziono

# Test
dane = [11, 15, 23, 45, 70]  # MUSI BYĆ POSORTOWANA!
wynik = binary_search(dane, 45)
print(f"Element 45 znajduje się na indeksie: {wynik}")  # 3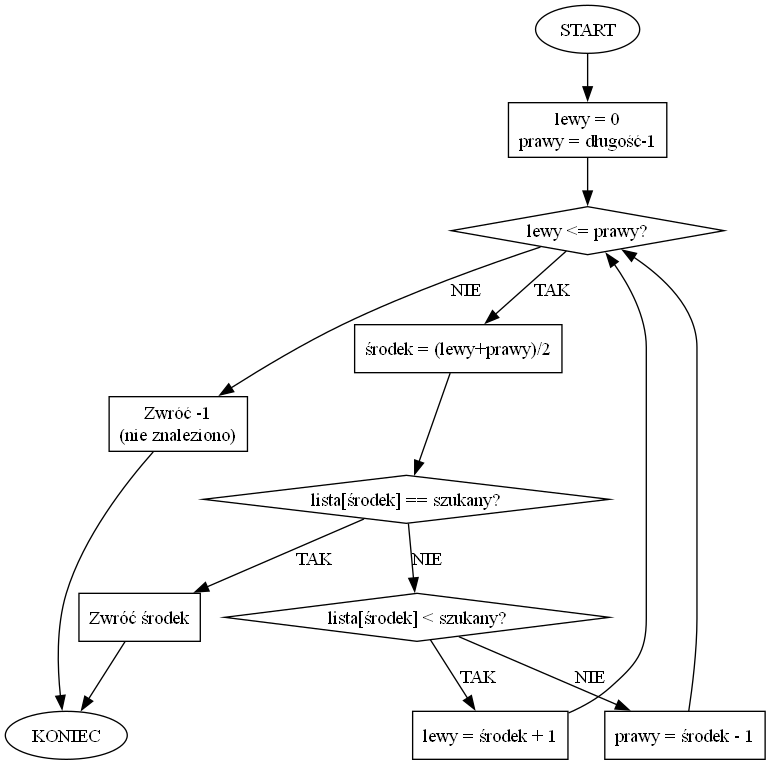
Wizualizacja:
Szukamy: 45
[11, 15, 23, 45, 70]
 L       M       P    środek=23, 45>23 → szukaj w prawo

         [45, 70]
          L   P       środek=45, znaleziono! ✓
Przeszukiwanie binarne – rekurencyjne
def binary_search_recursive(lista, szukany, lewy=0, prawy=None):
    """Przeszukiwanie binarne (rekurencyjne)."""
    if prawy is None:
        prawy = len(lista) - 1

    # Warunek bazowy
    if lewy > prawy:
        return -1

    # Znajdź środek
    srodek = (lewy + prawy) // 2

    if lista[srodek] == szukany:
        return srodek
    elif lista[srodek] < szukany:
        return binary_search_recursive(lista, szukany, srodek + 1, prawy)
    else:
        return binary_search_recursive(lista, szukany, lewy, srodek - 1)

# Test
dane = [11, 15, 23, 45, 70]
wynik = binary_search_recursive(dane, 70)
print(f"Element 70 znajduje się na indeksie: {wynik}")  # 4
Porównanie przeszukiwania
| Algorytm | Złożoność | Wymagania | Najlepsze dla |
|---|---|---|---|
| Linear Search | O(n) | Brak | Małe lub nieposortowane listy |
| Binary Search | O(log n) | Lista posortowana | Duże, posortowane listy |
Przykład: Dla n=1,000,000
- Linear: max 1,000,000 porównań
- Binary: max ~20 porównań!
Praktyczne przykłady
Przykład 1: Benchmark sortowania
import time
import random

def benchmark_sort(funkcja_sort, dane, nazwa):
    """Mierzy czas sortowania."""
    kopia = dane.copy()
    start = time.time()
    funkcja_sort(kopia)
    koniec = time.time()
    print(f"{nazwa}: {koniec - start:.4f}s")

# Wygeneruj dane
dane = [random.randint(1, 1000) for _ in range(5000)]

print("Benchmark sortowania (5000 elementów):")
benchmark_sort(bubble_sort, dane, "Bubble Sort")
benchmark_sort(selection_sort, dane, "Selection Sort")
benchmark_sort(insertion_sort, dane, "Insertion Sort")
benchmark_sort(merge_sort, dane, "Merge Sort")
benchmark_sort(quick_sort, dane, "Quick Sort")
benchmark_sort(sorted, dane, "Python sorted()")
Przykład 2: Wyszukiwanie w bazie danych
class BazaDanych:
    def __init__(self):
        self.dane = []

    def dodaj(self, rekord):
        self.dane.append(rekord)
        # Sortuj po dodaniu (dla binary search)
        self.dane.sort(key=lambda x: x['id'])

    def znajdz_linear(self, id):
        """Wyszukiwanie liniowe."""
        for rekord in self.dane:
            if rekord['id'] == id:
                return rekord
        return None

    def znajdz_binary(self, id):
        """Wyszukiwanie binarne."""
        lewy, prawy = 0, len(self.dane) - 1

        while lewy <= prawy:
            srodek = (lewy + prawy) // 2
            if self.dane[srodek]['id'] == id:
                return self.dane[srodek]
            elif self.dane[srodek]['id'] < id:
                lewy = srodek + 1
            else:
                prawy = srodek - 1

        return None

# Test
db = BazaDanych()
db.dodaj({'id': 1, 'imie': 'Jan'})
db.dodaj({'id': 5, 'imie': 'Anna'})
db.dodaj({'id': 3, 'imie': 'Piotr'})

print(db.znajdz_binary(5))  # {'id': 5, 'imie': 'Anna'}
Wbudowane funkcje Pythona
Python ma wbudowane, bardzo zoptymalizowane funkcje sortowania.
# sorted() - zwraca nową posortowaną listę
dane = [3, 1, 4, 1, 5, 9, 2, 6]
posortowane = sorted(dane)
print(posortowane)  # [1, 1, 2, 3, 4, 5, 6, 9]

# sort() - sortuje in-place
dane = [3, 1, 4, 1, 5, 9, 2, 6]
dane.sort()
print(dane)  # [1, 1, 2, 3, 4, 5, 6, 9]

# Malejąco
dane.sort(reverse=True)
print(dane)  # [9, 6, 5, 4, 3, 2, 1, 1]

# Sortowanie z kluczem
osoby = [{'imie': 'Jan', 'wiek': 25},
         {'imie': 'Anna', 'wiek': 30}]
osoby.sort(key=lambda x: x['wiek'])
print(osoby)
Algorytm: Python używa Timsort (hybrydowy Merge Sort + Insertion Sort) – O(n log n).
Podsumowanie
Sortowanie:
- Bubble Sort – O(n²), prosty, edukacyjny
- Selection Sort – O(n²), prosty
- Insertion Sort – O(n²), dobry dla małych/prawie posortowanych
- Merge Sort – O(n log n), stabilny, wymaga pamięci
- Quick Sort – O(n log n) średnio, najszybszy praktycznie
- Python sort() – Timsort, O(n log n), używaj tego!
Przeszukiwanie:
- Linear Search – O(n), dla nieposortowanych
- Binary Search – O(log n), dla posortowanych
Złożoność:
- O(1) < O(log n) < O(n) < O(n log n) < O(n²) < O(2^n)
Zasada: Dla małych danych (< 1000) różnice są niewielkie. Dla dużych – algorytm ma ogromne znaczenie!
PODSUMOWANIE
Algorytm to precyzyjny zestaw kroków prowadzących do rozwiązania problemu. W tej lekcji każdy algorytm sortowania lub wyszukiwania jest napisany jako funkcja operująca na liście.
Złożoność obliczeniowa (Big O)
- Mówi, jak szybko rośnie czas wykonania algorytmu, gdy rośnie liczba danych
n. Nie mierzy czasu w sekundach. - W lekcji O(n) opisuje najgorszy przypadek.
- Kolejność od najlepszej do najgorszej: O(1) < O(log n) < O(n) < O(n log n) < O(n²) < O(2^n) < O(n!).
- Pętla po liście to zwykle O(n), pętla w pętli po tej samej liście to O(n²).
Sortowanie
| Algorytm | Idea w jednym zdaniu | Złożoność |
|---|---|---|
| Bubble Sort | porównuje sąsiadów i zamienia, jeśli są w złej kolejności | O(n²), najlepszy O(n) |
| Selection Sort | znajduje minimum i wstawia je na początek | O(n²) zawsze |
| Insertion Sort | wstawia kolejny element w posortowaną część (jak karty w ręce) | O(n²), najlepszy O(n) |
| Merge Sort | dzieli na połowy, sortuje rekurencyjnie, scala | O(n log n) zawsze |
| Quick Sort | wybiera pivot, dzieli na mniejsze / równe / większe | O(n log n) średnio, O(n²) najgorzej |
- Algorytm jest stabilny, jeśli zachowuje kolejność równych elementów. Według tabeli z lekcji stabilne są Bubble, Insertion i Merge Sort.
- Bubble, Selection i Insertion Sort zmieniają przekazaną listę. Wersje
merge_sortiquick_sortz lekcji zwracają nową listę i nie zmieniają oryginału. - Algorytmy
merge_sortiquick_sortsą rekurencyjne. Mają warunek bazowy (len(lista) <= 1) i wywołują same siebie na mniejszych częściach listy.
Przeszukiwanie
- Liniowe – sprawdza elementy po kolei, O(n). Działa na każdej liście.
- Binarne – sprawdza środek i odrzuca połowę listy, O(log n). Lista musi być posortowana.
- Obie funkcje zwracają indeks znalezionego elementu albo
-1, gdy elementu nie ma.
Wbudowane narzędzia: sorted(lista) zwraca nową listę, lista.sort() sortuje na miejscu. Oba używają Timsortu, O(n log n). W praktyce używamy ich zamiast własnych implementacji.
Typowe źródła błędów
- Binary search na liście, która nie jest posortowana.
- Warunek
while lewy < prawyzamiastwhile lewy <= prawyw binary search. - Użycie
merge_sort(dane)bez przypisania wyniku (dane = merge_sort(dane)). - Przypisanie
wynik = dane.sort()–sort()zwracaNone. - Pomyłka w granicach pętli w Bubble Sort (
range(0, n - i - 1)).
Minimum, które powinno wejść w pamięć
Jeżeli masz zapamiętać tylko kilka rzeczy z tej lekcji, zapamiętaj te:
- Kolejność złożoności: O(1) < O(log n) < O(n) < O(n log n) < O(n²).
- Trzy proste sortowania (Bubble, Selection, Insertion) to O(n²). Merge Sort jest O(n log n) zawsze. Quick Sort jest O(n log n) średnio i O(n²) w najgorszym przypadku.
- Zamiana dwóch elementów w Pythonie:
lista[i], lista[j] = lista[j], lista[i]. - Binary search działa tylko na posortowanej liście. Warunek pętli to
while lewy <= prawy, a środek to(lewy + prawy) // 2. - Linear search: O(n), działa na każdej liście. Binary search: O(log n). Dla 1 000 000 elementów to około 20 porównań zamiast miliona.
- Rekurencja potrzebuje warunku bazowego (
len(lista) <= 1lublewy > prawy). sorted(lista)→ nowa lista,lista.sort()→ zmienia listę i zwracaNone. W praktyce używaj wbudowanych.merge_sortiquick_sortz lekcji zwracają nową listę, więc wynik trzeba przypisać do zmiennej.- Stabilny = zachowuje kolejność równych elementów.
Ściągawka – najważniejsze polecenia i składnia
Złożoność
| Notacja | Nazwa | Przykład |
|---|---|---|
| O(1) | stała | lista[0] |
| O(log n) | logarytmiczna | przeszukiwanie binarne |
| O(n) | liniowa | pętla for, przeszukiwanie liniowe |
| O(n log n) | liniowo-logarytmiczna | Merge Sort, Quick Sort (średnio) |
| O(n²) | kwadratowa | pętla w pętli, Bubble / Selection / Insertion Sort |
Sortowanie – porównanie
| Algorytm | Najlepszy | Najgorszy | Pamięć | Stabilny |
|---|---|---|---|---|
| Bubble | O(n) | O(n²) | O(1) | tak |
| Selection | O(n²) | O(n²) | O(1) | nie |
| Insertion | O(n) | O(n²) | O(1) | tak |
| Merge | O(n log n) | O(n log n) | O(n) | tak |
| Quick | O(n log n) | O(n²) | O(log n) | nie |
Zamiana elementów i granice pętli w Bubble Sort
lista[j], lista[j + 1] = lista[j + 1], lista[j]

for i in range(n):
    for j in range(0, n - i - 1):
        ...
Wyszukiwanie liniowe (szkielet)
for i in range(len(lista)):
    if lista[i] == szukany:
        return i
return -1
Wyszukiwanie binarne (szkielet) – lista musi być posortowana
lewy = 0
prawy = len(lista) - 1
while lewy <= prawy:
    srodek = (lewy + prawy) // 2
    if lista[srodek] == szukany:
        return srodek
    elif lista[srodek] < szukany:
        lewy = srodek + 1
    else:
        prawy = srodek - 1
return -1
Schemat rekurencji (Merge Sort / Quick Sort)
if len(lista) <= 1:      # warunek bazowy
    return lista
...                      # podział na mniejsze części
return ...               # wywołanie funkcji na częściach + połączenie wyników
Wbudowane sortowanie
sorted(lista)                       # nowa lista, oryginał bez zmian
lista.sort()                        # sortuje lista, zwraca None
lista.sort(reverse=True)            # malejąco
lista.sort(key=lambda x: x['wiek']) # po wybranym polu słownika
Quiz – sprawdź się
Pytanie 1. Który z algorytmów sortowania omawianych w lekcji ma złożoność O(n log n) w każdym przypadku (najlepszym, średnim i najgorszym) i jest stabilny? Co oznacza „stabilny”?
Pytanie 2. Uporządkuj złożoności od najszybszej do najwolniejszej: O(n²), O(1), O(n log n), O(log n), O(n).
Pytanie 3. Przeanalizuj kod:
def f(lista):
    for a in lista:
        for b in lista:
            print(a, b)
a) Jaka jest złożoność funkcji f? b) Ile razy zostanie wykonany print, gdy lista ma 4 elementy?
Pytanie 4. Co zostanie wyświetlone? (To jedno przejście Bubble Sort bez flagi i bez zewnętrznej pętli.)
dane = [5, 2, 4, 1]
for j in range(len(dane) - 1):
    if dane[j] > dane[j + 1]:
        dane[j], dane[j + 1] = dane[j + 1], dane[j]
print(dane)
Co można powiedzieć o ostatnim elemencie listy po tym przejściu?
Pytanie 5. Uzupełnij kod Insertion Sort w miejscu ____:
for i in range(1, len(lista)):
    key = lista[i]
    j = i - 1
    while j >= 0 and lista[j] > key:
        lista[j + 1] = lista[j]
        j -= 1
    lista[j + 1] = ____
Pytanie 6. Znajdź błąd. Dlaczego wywołanie zwraca -1, choć element jest na liście?
def binary_search(lista, szukany):
    lewy = 0
    prawy = len(lista) - 1
    while lewy < prawy:
        srodek = (lewy + prawy) // 2
        if lista[srodek] == szukany:
            return srodek
        elif lista[srodek] < szukany:
            lewy = srodek + 1
        else:
            prawy = srodek - 1
    return -1

print(binary_search([7], 7))
Pytanie 7. Poprawna funkcja binary_search (z lekcji) została wywołana tak:
print(binary_search([40, 10, 30, 20], 20))Co zostanie wyświetlone i dlaczego? Jak zmienić wywołanie, aby wynik był poprawny?
Pytanie 8. Co zostanie wyświetlone?
dane = [3, 1, 2]
wynik = dane.sort()
print(wynik)
print(dane)
Pytanie 9. Używasz funkcji merge_sort z lekcji. Co zostanie wyświetlone i dlaczego lista nie jest posortowana? Jak poprawić kod?
dane = [3, 1, 2]
merge_sort(dane)
print(dane)
Pytanie 10. Uzupełnij kod tak, aby lista osoby została posortowana malejąco według wieku:
osoby = [{'imie': 'Jan', 'wiek': 25},
         {'imie': 'Anna', 'wiek': 30},
         {'imie': 'Ewa', 'wiek': 19}]
osoby.sort(____)
print([o['imie'] for o in osoby])
Jakie imiona zostaną wyświetlone po poprawnym uzupełnieniu?
Pytanie 11. Zadanie praktyczne. Napisz funkcję czy_posortowana(lista), która zwraca True, jeśli elementy listy są ułożone rosnąco (równe sąsiednie elementy są dozwolone), a w przeciwnym razie False. Sprawdź ją dla list [1, 2, 2, 5], [3, 1, 2] i [].
Odpowiedzi
1. Merge Sort. Stabilny oznacza, że elementy o równych wartościach zachowują względną kolejność z listy wejściowej.
2. O(1) < O(log n) < O(n) < O(n log n) < O(n²).
3. a) O(n²) (pętla w pętli po tej samej liście). b) 4 · 4 = 16 razy.
4. [2, 4, 1, 5]. Po jednym przejściu największy element (5) jest na końcu listy, ale reszta nie musi być jeszcze posortowana.
5. key. Zapamiętany element wstawiamy na zwolnione miejsce lista[j + 1].
6. Warunek while lewy < prawy kończy pętlę, zanim sprawdzony zostanie ostatni pozostały element (przy jednoelementowej liście lewy == prawy == 0, więc pętla w ogóle się nie wykona). Poprawnie: while lewy <= prawy. Po poprawce wynik to 0.
7. Zostanie wyświetlone -1, choć 20 jest na liście (indeks 3). Lista nie jest posortowana, a binary search działa tylko na posortowanej liście. Poprawne wywołanie: binary_search(sorted([40, 10, 30, 20]), 20). Po sortowaniu lista to [10, 20, 30, 40], więc wynik to 1.
8. None, a potem [1, 2, 3]. Metoda sort() sortuje listę na miejscu i zwraca None. Do zmiennej przypisujemy wynik sorted(dane), a nie dane.sort().
9. Zostanie wyświetlone [3, 1, 2]. merge_sort zwraca nową posortowaną listę i nie zmienia oryginału, a wynik nie został nigdzie zapisany. Poprawnie: dane = merge_sort(dane) (wynik [1, 2, 3]).
10. key=lambda x: x['wiek'], reverse=True. Wyświetlone zostanie ['Anna', 'Jan', 'Ewa'].
11. Przykładowe rozwiązanie:
def czy_posortowana(lista):
    for i in range(len(lista) - 1):
        if lista[i] > lista[i + 1]:
            return False
    return True

print(czy_posortowana([1, 2, 2, 5]))  # True
print(czy_posortowana([3, 1, 2]))     # False
print(czy_posortowana([]))            # True
Wystarczy znaleźć jedną parę sąsiadów w złej kolejności. Dla pustej listy pętla się nie wykona, więc wynik to True. Złożoność tego rozwiązania to O(n).